GB200 NVL72 FP8:启用 MTP 与关闭投机解码的对比
在 GB200 NVL72 FP8(NVIDIA Blackwell)上运行 Qwen 3.5 397B-A17B 时,对比启用 MTP和关闭投机解码两种配置的表现,涵盖不同 LLM 工作负载下的吞吐量、成本和交互性。可通过下方图表控件切换序列长度和指标,操作方式与主推理图表相同。
不同推理引擎统计 MTP 接受率的口径并不一致,因此同一条曲线上来自不同引擎的数据点不可直接比较。在交互性相同的情况下,吞吐量和成本差异可能来自引擎本身,并不完全代表投机解码带来的收益。跨引擎对比时请谨慎解读。
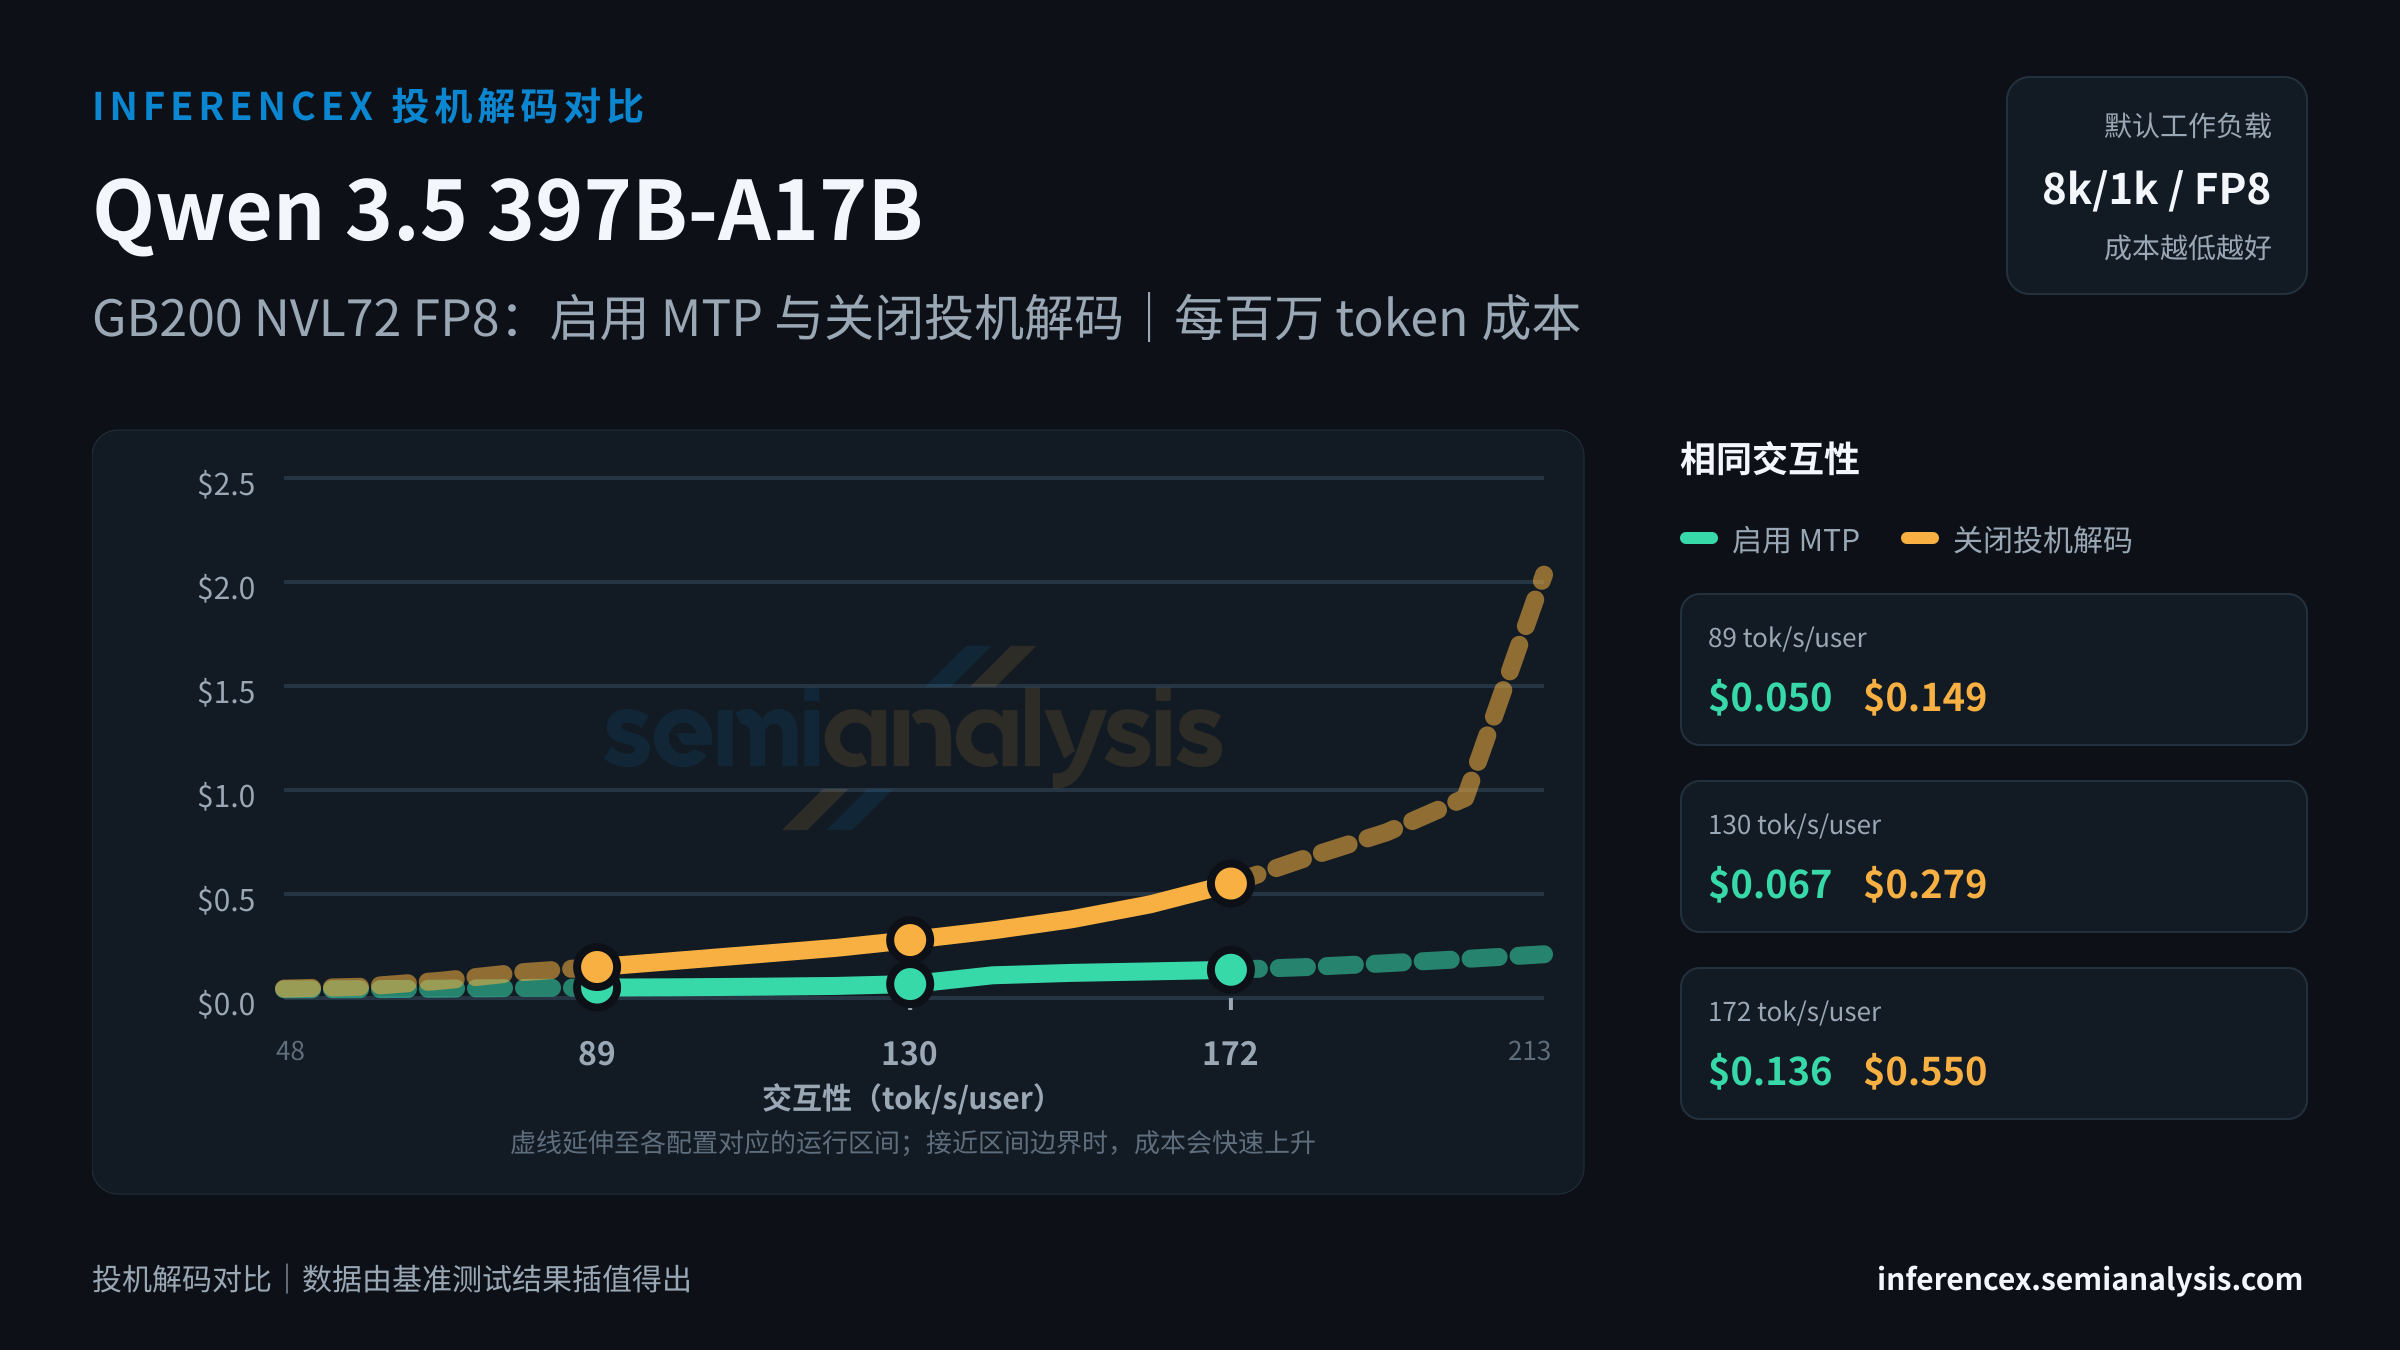
89 tok/s/user 接近 48–213 tok/s/user 交互性区间的下限。在这一运行点,启用 MTP 时,吞吐量为 10304 tok/s/chip,每百万 token 成本为 $0.05;关闭投机解码时,吞吐量为 3468 tok/s/chip,每百万 token 成本为 $0.15。MTP 的成本效率高出 197%;MTP 的单芯片吞吐量高出 197%。投机解码的收益因工作负载而异;输出较短的 prompt 通常收益较小。
在 GB200 NVL72 FP8 上运行 Qwen 3.5 397B-A17B,目标交互性设为 130 tok/s/user:启用 MTP 时,吞吐量为 7708 tok/s/chip,每百万 token 成本为 $0.07;关闭投机解码时,吞吐量为 1855 tok/s/chip,每百万 token 成本为 $0.28。MTP 的成本效率高出 316%;MTP 的单芯片吞吐量高出 316%。投机解码通过接受 draft token 降低每 token 延迟;收益因工作负载和 prompt 分布而异。
Qwen 3.5 397B-A17B 在 GB200 NVL72 FP8 上的目标交互性设为 172 tok/s/user:启用 MTP 时,吞吐量为 3808 tok/s/chip,每百万 token 成本为 $0.14;关闭投机解码时,吞吐量为 939 tok/s/chip,每百万 token 成本为 $0.55。MTP 的成本效率高出 306%;MTP 的单芯片吞吐量高出 306%。draft token 接受率决定了在给定并发数下,投机解码是提升性能还是拖累性能。 (以上数据基于此 URL 固定的 8k/1k · fp8 工作负载;切换序列长度或模型后,表格和图表会同步更新。表格始终使用本页指定的精度,控件中的精度选项只影响图表。)
| 指标 | 交互性(tok/s/user) | 交互性(tok/s/user) | 交互性(tok/s/user) |
|---|---|---|---|
| 吞吐量(tok/s/chip) | 启用 MTP:10304.0关闭投机解码:3467.7 | 启用 MTP:7708.5关闭投机解码:1854.9 | 启用 MTP:3808.3关闭投机解码:938.7 |
| 成本($/M tok) | 启用 MTP:$0.050关闭投机解码:$0.149 | 启用 MTP:$0.067关闭投机解码:$0.279 | 启用 MTP:$0.136关闭投机解码:$0.550 |
| tok/s/MW | 启用 MTP:5510151关闭投机解码:1854362 | 启用 MTP:4122183关闭投机解码:991918 | 启用 MTP:2036551关闭投机解码:502002 |
| 并发数 | 启用 MTP:~1083关闭投机解码:~38 | 启用 MTP:~437关闭投机解码:~13 | 启用 MTP:~50关闭投机解码:~5 |
推理性能
不同模型、硬件配置和服务参数下,来自 AgentX 场景的智能体推理指标与固定序列推理指标。